ダンス カバー クリエーター
オリジナル キャラクターで全トレンド振付に乗ります。カメラに顔はなく、動きを再学習する必要はありません — トレンドあたり 1 つの深度パス。
同じ動き、
全く新しい ダンサー。
Edition 10 — 深度主導のモーション転換
ステップ 1 はバイラル ダンス クリップを深度映像に平坦化します — 動き、リズム、カメラは生き残りますが、ダンサーの顔、服装、背景は生き残りません。ステップ 2 は新しいキャラクターとシーンを 1 つの参照画像に固定します。ステップ 3 は両者を Seedance 2.0 参照映像生成に渡し、キャラクター上の正確な振付を再レンダリングします。実行全体は以下のコンソールで行われます。
下の Seedance プロンプトは英語に翻訳されたクリエーター ワークフローです — 同じ構造、同じ制約。Seedance 2.0 は英語と中国語をネイティブに読み込みます。@video_1 と @image_1 トークンは変更しないでください。
以下のコンバーターで15秒以下のビデオクリップを実行してください — Depth Anythingをブラウザー内で完全に実行し、無料で、クリップはデバイスを離れることはありません。振付、タイミング、体重、カメラの動きは保持されます。ダンサーの顔、衣装、場所は保持されません。
ブラウザで完全に実行されます。クリップはお客様のデバイスから出ることはありません。初回実行時に~50MBのモデルをダウンロードし、その後キャッシュされます。
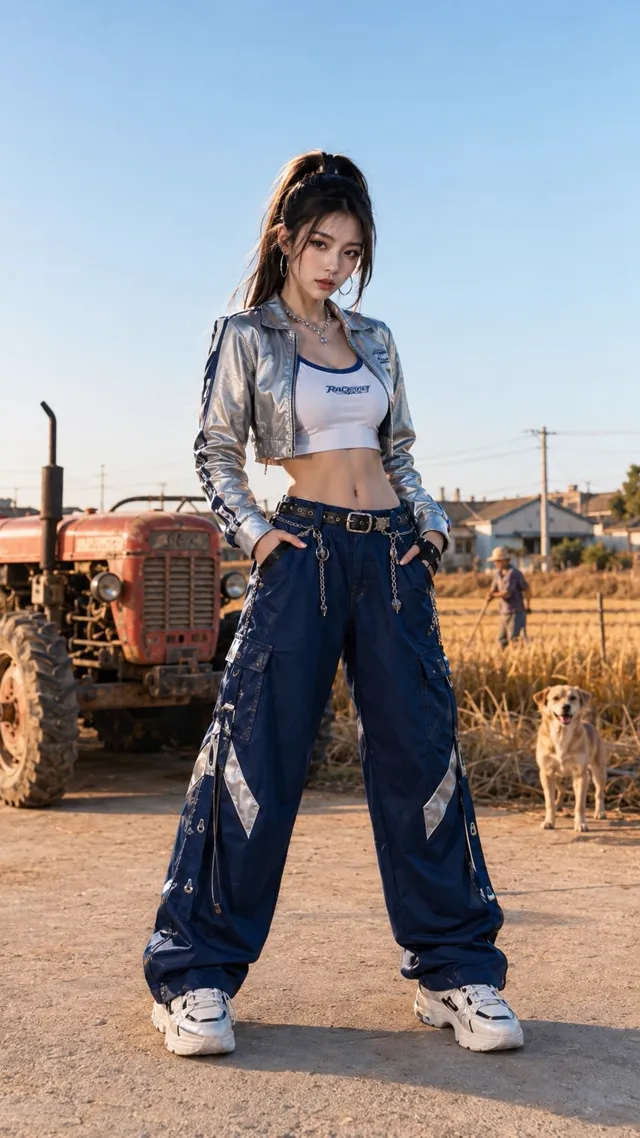
単一の参照画像が全体の新しいアイデンティティを担います — ここでは、農場の脱穀床にテックウェア ダンサーがいる場面で、赤いトラクター、金色の畑、村の犬がいます。任意のモデルで画像スタジオに生成し、映像プロンプトの後で同じ記述子を再利用すれば、何もずれません。
深度映像を @video_1 として、参照画像を @image_1 として Seedance 2.0 参照映像生成スタジオにアップロードし、逐語的なプロンプトを貼り付けてください。固定カメラ、単一 15 秒テイク、厳密な参照フォロー ルール — 新しい動き、シーンのずれはありません。
Generate a 15-second, 9:16 vertical, high-definition photorealistic dance video shot from a fixed camera position in one continuous take. No cuts, no transitions, no push-in or pull-out, no orbiting — for the entire video.

@video_1 is the Depth dance reference, used only to control the movements, rhythm, body weight shifts, turn directions, dancer position, and camera framing. Strictly follow the choreography order in the reference and reproduce every arm swing, hip twist, knee lift, cross step, jump, and pause as closely as possible. Do not add new moves.

@image_1 is the only character and scene reference. Keep the adult East Asian female dancer from the image, around 20 years old, stable throughout: same face, figure, high ponytail, and outfit — silver cropped techwear jacket, white sports bra, loose dark-blue cargo work pants, metal waist chain, and white sneakers.

Keep the rural farmland scene from the image: a flat threshing yard, an old red tractor, golden fields, villagers, and a Chinese rural dog. The dancer stays at the center of the frame dancing earnestly; background people and the village dog give only slight natural reactions — they do not dance along, steal focus, or block the dancer.

The dancer is tall and slender with a small waist and long legs; the moves are cool, fierce, relaxed, and powerful. Use a slightly low-angle full-body medium-wide shot, without exaggerated perspective. Keep the dancer fully in frame from head to shoes, with feet planted firmly on the ground.

The high ponytail, jacket hem, pant legs, and waist chain swing naturally with the movements. Real afternoon sunlight, real skin texture, and a real camera feel.

Avoid: face swaps, outfit changes, character scaling, feet sliding, body clipping, fused limbs, duplicated background people, villagers dancing along, the dog dancing, the tractor moving, camera cuts, subtitles, text, logos, watermarks.
Model — seedance-2-beta
1 つの深度映像は全シーズン分のキャラクターを運ぶことができます — モーションを保持し、毎回新しい参照画像で再実行してください。
すべてのテンプレートを閲覧AIダンス深度映像テンプレートは 3 パス モーション転換ワークフローです。パス 1 は参照ダンス クリップを深度映像に変換します — すべてのアーム スウィング、ヒップ ツイスト、ジャンプ、カメラ移動を保持しているが、認識可能な顔、服装、場所を含まないグレースケール ジオメトリー マップです。パス 2 は新しいキャラクターとシーンを 1 つの参照画像として設計します。パス 3 は両者を Seedance 2.0 に渡し、キャラクター上、キャラクターの世界で元の振付を再レンダリングします。
この方法は韓国のクリエーター @impalementd によって共有され、このトラクター ダンス版は @MrLarus によるものです — 元の日課は Douyin クリエーター 周同学 によるもので、その容姿がパイプラインに入ることはありません。このページでワークフロー全体を実行します — ステップ 1 での深度抽出、上のコンソールでの両方の生成パス: GPT Image 2.0 image studio · Seedance 2.0 reference-to-video
モーションのみの転換
深度は振付、リズム、フレーミングを保持します。顔、服装、背景は Seedance 2.0 がクリップを見る前に削除されます。
スクリーニング防止入力
実在の顔や認識可能な IP を含むソース クリップは、すべてのティアでの入力レビューに定期的に失敗します。深度版は成功します — ジオメトリーを含んでおり、人々ではありません。
バイリンガル プロンプティング
Seedance 2.0 は中国語と英語をネイティブに読み込みます。ここのプロンプトはクリエーター元の中国語実行の英語翻訳です — どちらかの言語が機能します。
≤ 15 秒参照
最大 3 つの参照クリップ、合計 15 秒。ビデオ入力ティアは入出力秒を請求します — 両方をバジェットしてください。
実際の人物の容姿をパイプラインに入れずにバイラル振付をスクリーンに出したい誰もが。
オリジナル キャラクターで全トレンド振付に乗ります。カメラに顔はなく、動きを再学習する必要はありません — トレンドあたり 1 つの深度パス。
VTuber またはバーチャル アーティストを週単位で踊らせます。パーソナは、ソース クリップではなく参照画像から来るため、一貫性を保ちます。
ダンサーの容姿をライセンスしなくても、このマスコットを今週のダンス トレンドに乗せてください。同じパスでシーンをストアフロントに交換してください。
スタジオを予約する前に、異なる体、衣装、舞台での日課をプレビューしてください。深度映像は日課です。他のすべてはレンダリングし直します。
振付が重要でパフォーマーが交渉可能な場合、トレンドを再撮影するときに深度主導のモーション転換がなぜダンス カバーをフィルムに撮ることより優れているか。
See credit pricing · Seedance 2.0 Fast · Dance tutorial template
3 パス モーション転換ワークフローです:参照ダンス クリップを深度映像に変換し、新しいキャラクターとシーンを 1 つの参照画像として生成してから、Seedance 2.0 参照映像生成でキャラクター上の正確な振付を再レンダリングします。逐語的な Seedance プロンプトはこのページにあり、リミックスは無料です。
2 つの理由があります。創造的には、深度はコピーしたいものだけを保持します — モーション、リズム、体構造、カメラフレーミング — したがって新しいレンダリングはソースに視覚的に何も負わない。実際には、実際の顔または認識可能な IP を含むソース クリップはルーチンに入力スクリーニングに失敗します。深度映像はどちらも含まないため、同じ振付は使用可能になります。
このページのStep 1の組み込みエクストラクターを使用してください — WebGPU上のDepth Anythingでブラウザー内で完全に変換され、無料で、クリップはデバイスを離れることはありません(Chrome、Edge、Safariデスクトップで動作)。外部の深度ツールも機能します。Hugging Face Spacesでビデオ深度モデルを検索するか、Claudeに小さいGradio深度エクストラクターサイトを構築するよう依頼してください — これはワークフロー作成者が正確に行ったことです。
いいえ。深度映像には顔、肌、服装、背景を含まない — ジオメトリのみが時間とともにあります。最終的なレンダリングで表示されるすべてのものは参照画像とプロンプトから来ます。このページの例は、元のパフォーマーを生成されたテックウェア キャラクターで完全に置き換えます。
深度変換は容姿とフッテージ再利用の問題を削除しますが、元の振付と音声トラックは別々の権利です — ワークフロー独自のクリエーターはこれにフラグを付けています。商用利用については、ライセンスされた素材の場合と同じように日課とオーディオを扱ってください。例は、元のトラクター ダンスを Douyin クリエーター 周同学 にクレジットしています。
クリエーター元の中国語プロンプトの忠実な英語翻訳です — 同じ構造、同じ制約、同じ @video_1 と @image_1 トークン。Seedance 2.0 はネイティブにバイリンガルのため、両方のバージョンは同じように動作します:@video_1 の厳密な参照フォロー ルール、@image_1 の完全なアイデンティティ ロック、カメラ制約、およびネガティブ リスト。
1 つの画像生成に加えて 1 つの参照映像生成パス。ビデオ入力を請求するティアは入出力秒をカウントすることに注意してください — 15 秒の深度参照プラス 15 秒のレンダリングは約 30 秒のように請求されます。完全な実行は通常、ティアと解像度に応じて 90 ~ 140 クレジット程度に達します。
参照映像生成スタジオを開き、深度映像を参照映像(@video_1)として、キャラクター シートを参照画像(@image_1)としてアップロードし、9:16 と 15 秒を設定し、プロンプトを貼り付けてください。固定カメラと新しい動きは言語を保持してください — これはレンダリングが参照をビートごとにフォローするようにします。
深度映像を抽出し、キャラクター シートをロックし、逐語的なプロンプトを貼り付けてください — 上のコンソールは Seedance 2.0 パスを実行します。